Где система сейчас
3–4 мес. → 2 нед.
возраст самой старой активной ветки
3
крупных обновления по BRD, где работает AI-скилл слоя 1
1,5–3×
меньше доля веса страницы с компонентом в файле (замеры на тестовой и реальных файлах)
1 из 3
слой 1 работает, слой 2 прототип, слой 3 в плане
Контекст
При масштабировании продукта Solo-модель дизайнера становится точкой отказа: хаотичные ветки, слепые зоны, нарушенная гигиена хэндоффа. Я взял на себя задачу превратить это в управляемую систему без выделенной команды.
Ограничения
Без готовых референсов по автоматизации в Figma: собирал их сам через митапы, форумы, общение с дизайнерами и разборы на Хабре. Компания не выделяла отдельного времени, оптимизировал процессы параллельно с продуктовыми задачами. На всё дан срок 6 месяцев.
Порядок в ветках
Фундамент, без которого не работает остальная автоматизация!
Было
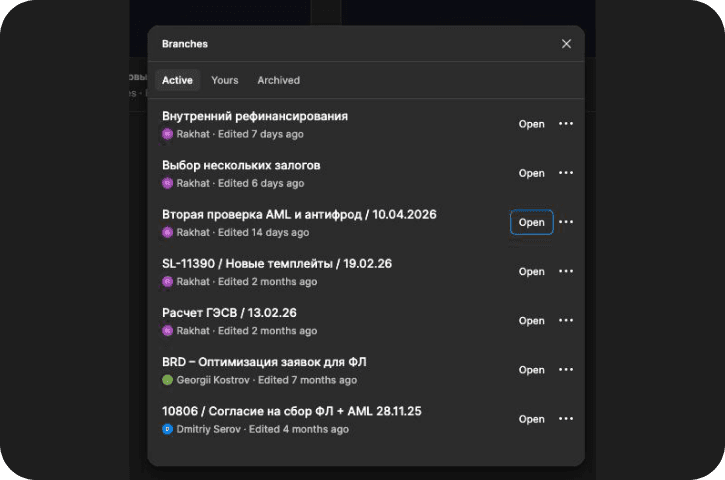
15–20 веток возрастом 3–4 месяца. Delivery-команда искала файлы только по прямым ссылкам.
Стало
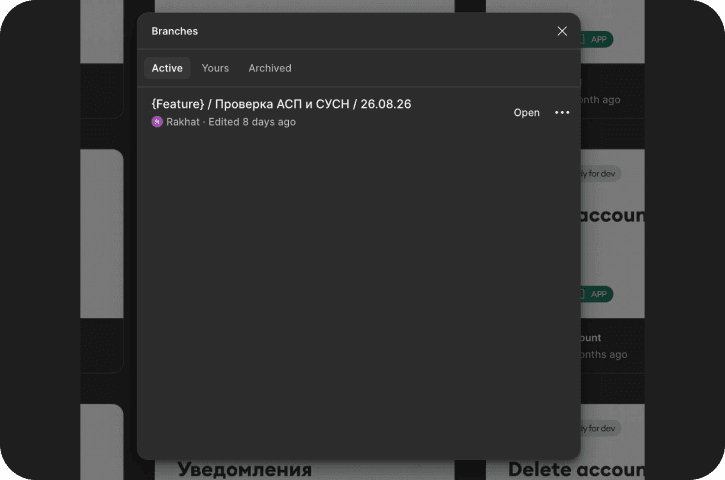
10 активных веток, самая старая живёт 2 недели (на согласовании).
Причина и авторство
Причиной стали запросы разработчиков: макеты было трудно искать. Принцип Main = Prod предложил бывший дизайн-лид, регламент и внедрение сделал я.
Main = Prod
в Main только то, что ушло в разработку;
1 ветка = 1 задача
1 ветка = 1 задача, живёт спринт;
Branch names
в названии тип работы: feature, fix, exp, refactor;
Чистка веток
перед ревью обновить ветку из Main и почистить макет.
Гипотезы
Edge-cases
Автоматическая генерация разных состояний закроет слепые зоны и снизит технические возвраты.
Про preflight-проверку
AI может ошибаться и что-то пропустить. Плагин проверяет по чётким правилам и ловит ошибки без исключений.
Про архитектуру
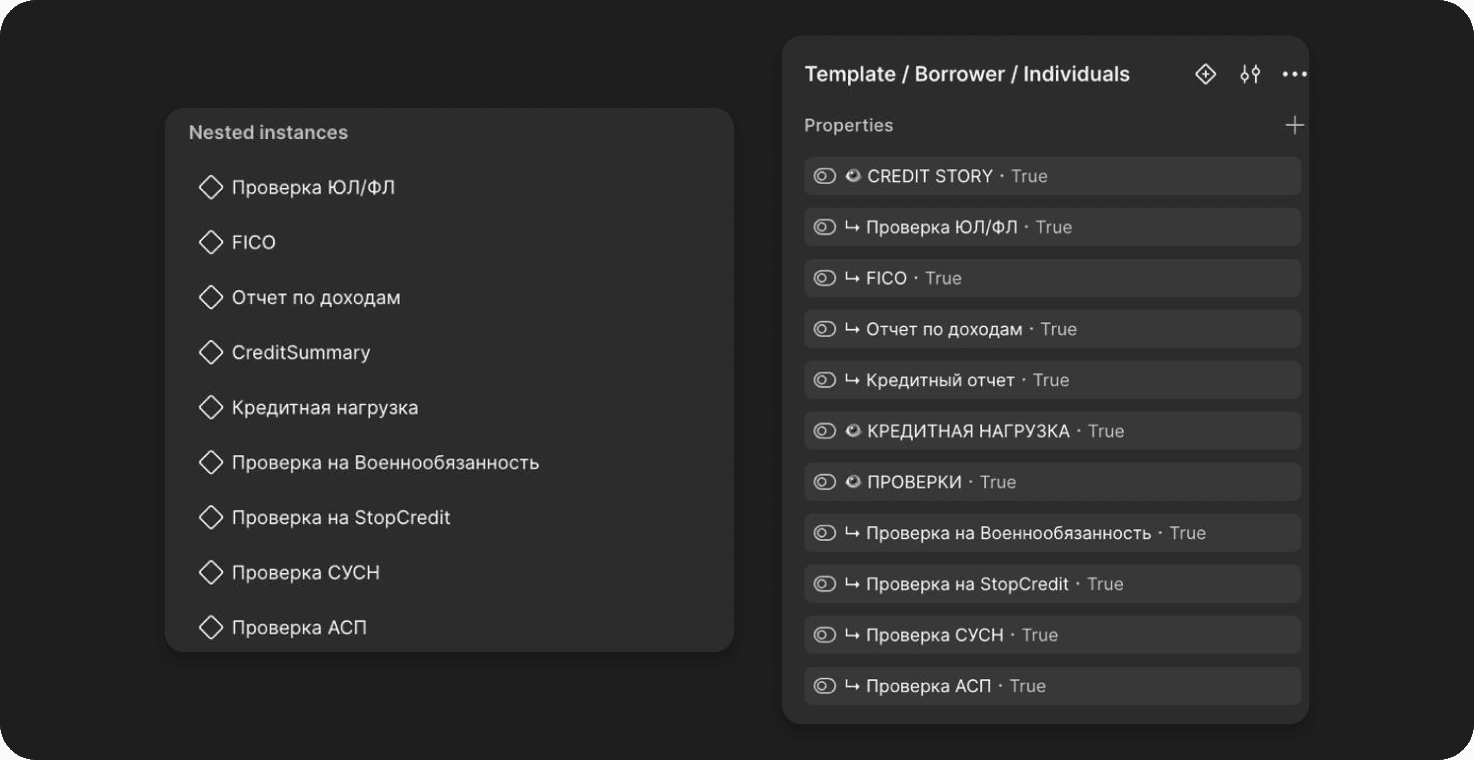
Nested instances снизят memory usage и риск падения файла на масштабе.
Про системный контроль
Серверный аудит сделает ревью объективным и независимым от внимательности человека.
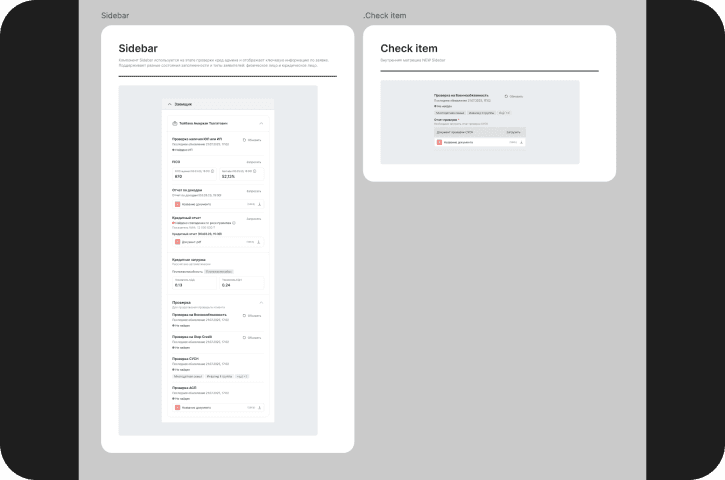
Компонент = внешний вид + правила
У каждого компонента теперь 2 части: как он выглядит и когда используется.
Как выглядит
Компонент собран из вложенных частей, как матрёшка.
Меняешь деталь - она обновляется везде, а файл не тяжелеет.
Когда и как используется
К компоненту приложено описание: в каких сценариях он появляется, какие у него состояния и что видит пользователь при ошибке. Разработчику не нужно гадать.
Эффект на вес файла
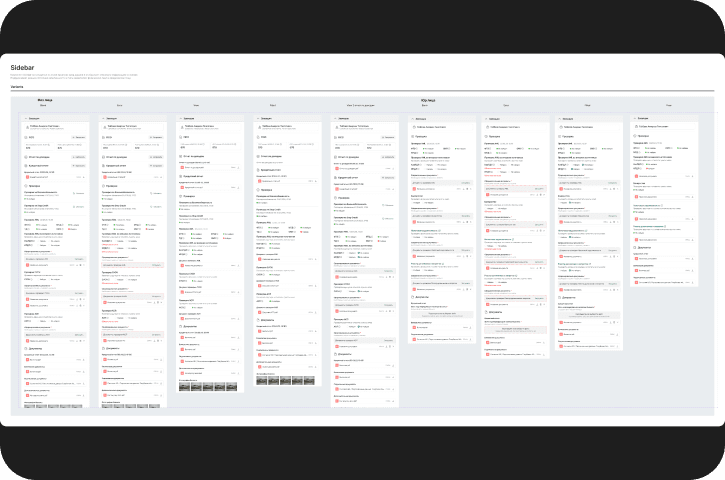
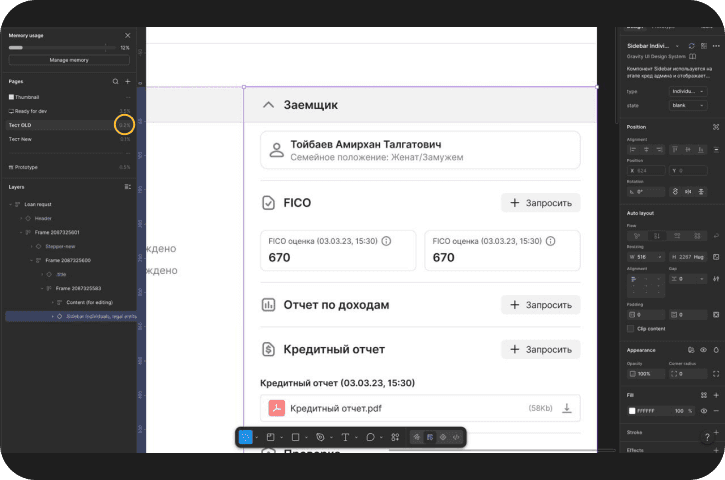
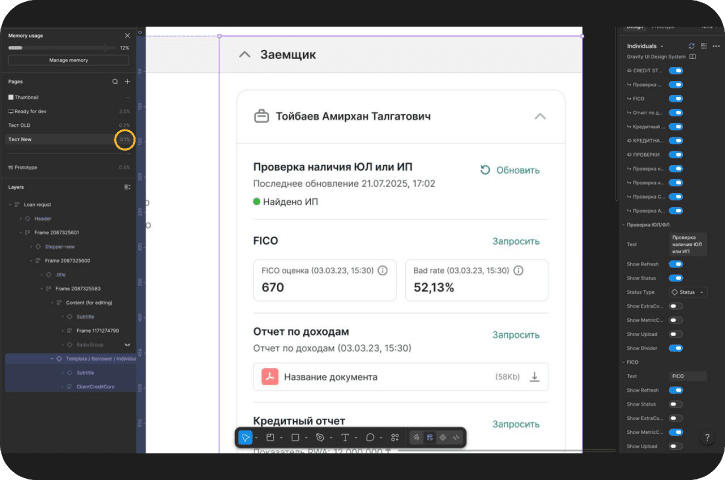
Замерял долю веса страницы с мастер-компонентом от веса всего файла. На тестовой странице: 0.2% → 0.1%. На реальных больших файлах эффект тоже есть, примерно в 1,5–3 раза, зависит от файла. Абсолютные цифры под NDA.
Архитектура: статус слоёв
Единый Rules Manifest для всех слоёв
AI Skills & SOP
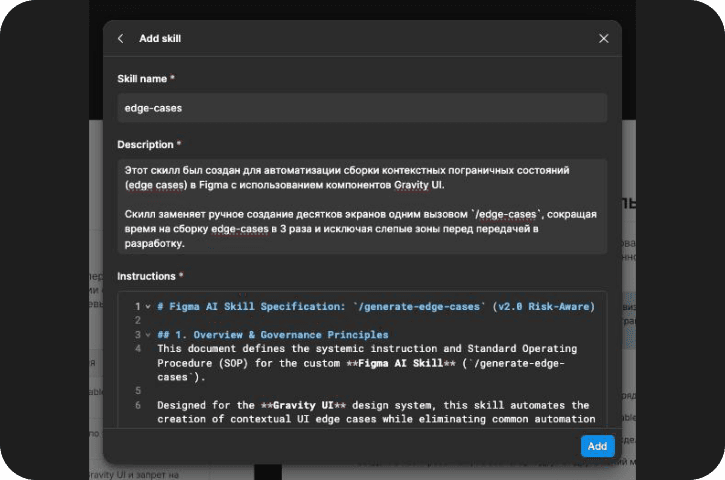
Скилл /generate-edge-cases на Decision Tables применён на 3 крупных обновлениях по BRD.
Figma Plugin MVP
Есть структура кода. Условие готовности: прогон на 3 реальных кейсах и ложные срабатывания ниже 5%.
Webhooks & REST API
Серверный аудит при статусе «Ready for review», Severity Matrix в комментариях Figma. Старт только после закрытия слоя 2.
Слой 1 в деле
Что скилл нашёл, а я пропустил
На одном из обновлений по BRD скилл сгенерировал состояние ошибки страницы, которое я не предусмотрел заранее. Такие пропуски и должен ловить слой 1: результат строится по Decision Tables и SOP.
Что со временем
На тестовой задаче скилл нашёл 4 кейса, те же, что я нашёл бы вручную. Выигрыш по времени небольшой. Главная ценность в воспроизводимости: результат не зависит от внимательности дизайнера, любой дизайнер команды получит тот же набор кейсов.
Команда и согласования
Систему выстраивал параллельно с продуктовыми задачами, без выделенной команды, но не в изоляции. Решения обсуждал с Product Owner, фронтенд- и мобильным разработчиками. PO и бывший дизайн-лид подкидывали идеи по развитию: принцип Main = Prod предложил бывший лид, регламент и внедрение сделал я.
Документация
Драфт на согласовании
Начинаю фиксировать знания: принципы nested instances, работа с Gravity UI, пошаговый SOP для дизайнера. Драфты готовы и отправлены на утверждение Product Owner. Цель: чтобы знания жили в общем инструменте, а не в личных файлах.
Риски и решения
AI-галлюцинации
Decision Tables, промпт ограничен SOP
Шторм событий API
Дебаунсинг, очередь по fileKey + versionId
Лимиты Figma API
Кэширование, экспоненциальный бэкофф
Деструктивный auto-fix
Авто-исправление только прямой привязки токенов
Человек - финальный decision maker. Автоприёмка веток запрещена, отчёт системы - сигнал для ревьюера.
Цели для измерения
Edge-кейсы
Проверить, насколько ускоряется проработка edge-кейсов. На 3 обновлениях выигрыш по времени небольшой, главный эффект в воспроизводимости и покрытии.
Zero-Return Handoff
Цель: чтобы переданные в delivery решения не возвращались на доработку. Baseline не зафиксирован, метрика вводится вместе со слоями 2–3, учёт с даты запуска.
Качество линтера
Полнота проверки по правилам: 100%. Доля ложных срабатываний ниже 5%. Это условие готовности слоя 2.
Чему научился
Без готовых референсов
Референсов по автоматизации DesignOps в Figma не было, поэтому собирал их сам: митапы, форумы, общение с дизайнерами других компаний и разборы на Хабре от дизайнеров крупных российских компаний. Идеи оттуда перенял при построении системы.
Метрики с первого дня
В следующий раз фиксировал бы метрики с первого дня, а не восстанавливал по version history. Baseline по возвратам от разработки я не зафиксировал, поэтому эта метрика пока остаётся целью.
Roadmap
До дедлайна (2 месяца):
1. Слой 2. Плагин до MVP: прогон на 3 реальных кейсах, ложные срабатывания ниже 5%
2. Слой 3 до MVP, если слой 2 закрыт вовремя: Ready for review → Rules Engine → Severity Matrix
3. Документация и онбординг для дизайнеров
4. Первые цифры руководству, учёт с даты запуска
Дальше: Soft Gates (error в отчёте как основание отклонить мерж); бизнес-валидация (Conversion, Task Success Rate)